南京软件开发项目需求梳理与系统集成实施要点解析
当业务需求遇上系统碎片化:南京企业数字化转型的真正痛点
很多南京本土制造企业和科技公司在推进信息化时,都面临一个尴尬局面:财务、生产、CRM、OA各自为政,数据孤岛林立。我们接触过一家年产值过亿的装备制造客户,光ERP和MES之间的数据同步就需要人工导出导入,每天耗时两小时以上。这种内耗不是个例,而是南京科技企业普遍存在的隐性成本。
问题的根源往往不在单一软件本身,而在于缺乏一套从需求梳理到系统集成的全局方法论。业务部门提需求停留在“我要一个能看的报表”,IT部门则困于“历史债务”难以自拔,最终项目上线即落后。
科技研发驱动下的需求梳理:从“伪需求”到“真场景”
在南京迪一科技的项目实践中,我们坚持将科技研发思维前置到需求调研阶段。不是简单记录“用户想要什么”,而是通过业务流程图解、数据流分析、接口边界定义,把模糊的期望转译成可度量的功能清单与非功能指标(性能、并发、安全)。比如,针对仓储物流场景,我们曾通过一周的现场跟单,发现看似“合理”的PDA扫码需求,实际有30%操作是无效动作,最终通过流程再造而非增加开发量解决了问题。
这一阶段的核心交付物是《需求规格说明书》与《系统集成接口规范》,前者约束范围,后者定义边界。缺少这两份文档,后续的软件开发必然陷入无休止的变更循环。
系统集成的实施要点:协议、数据与容错设计
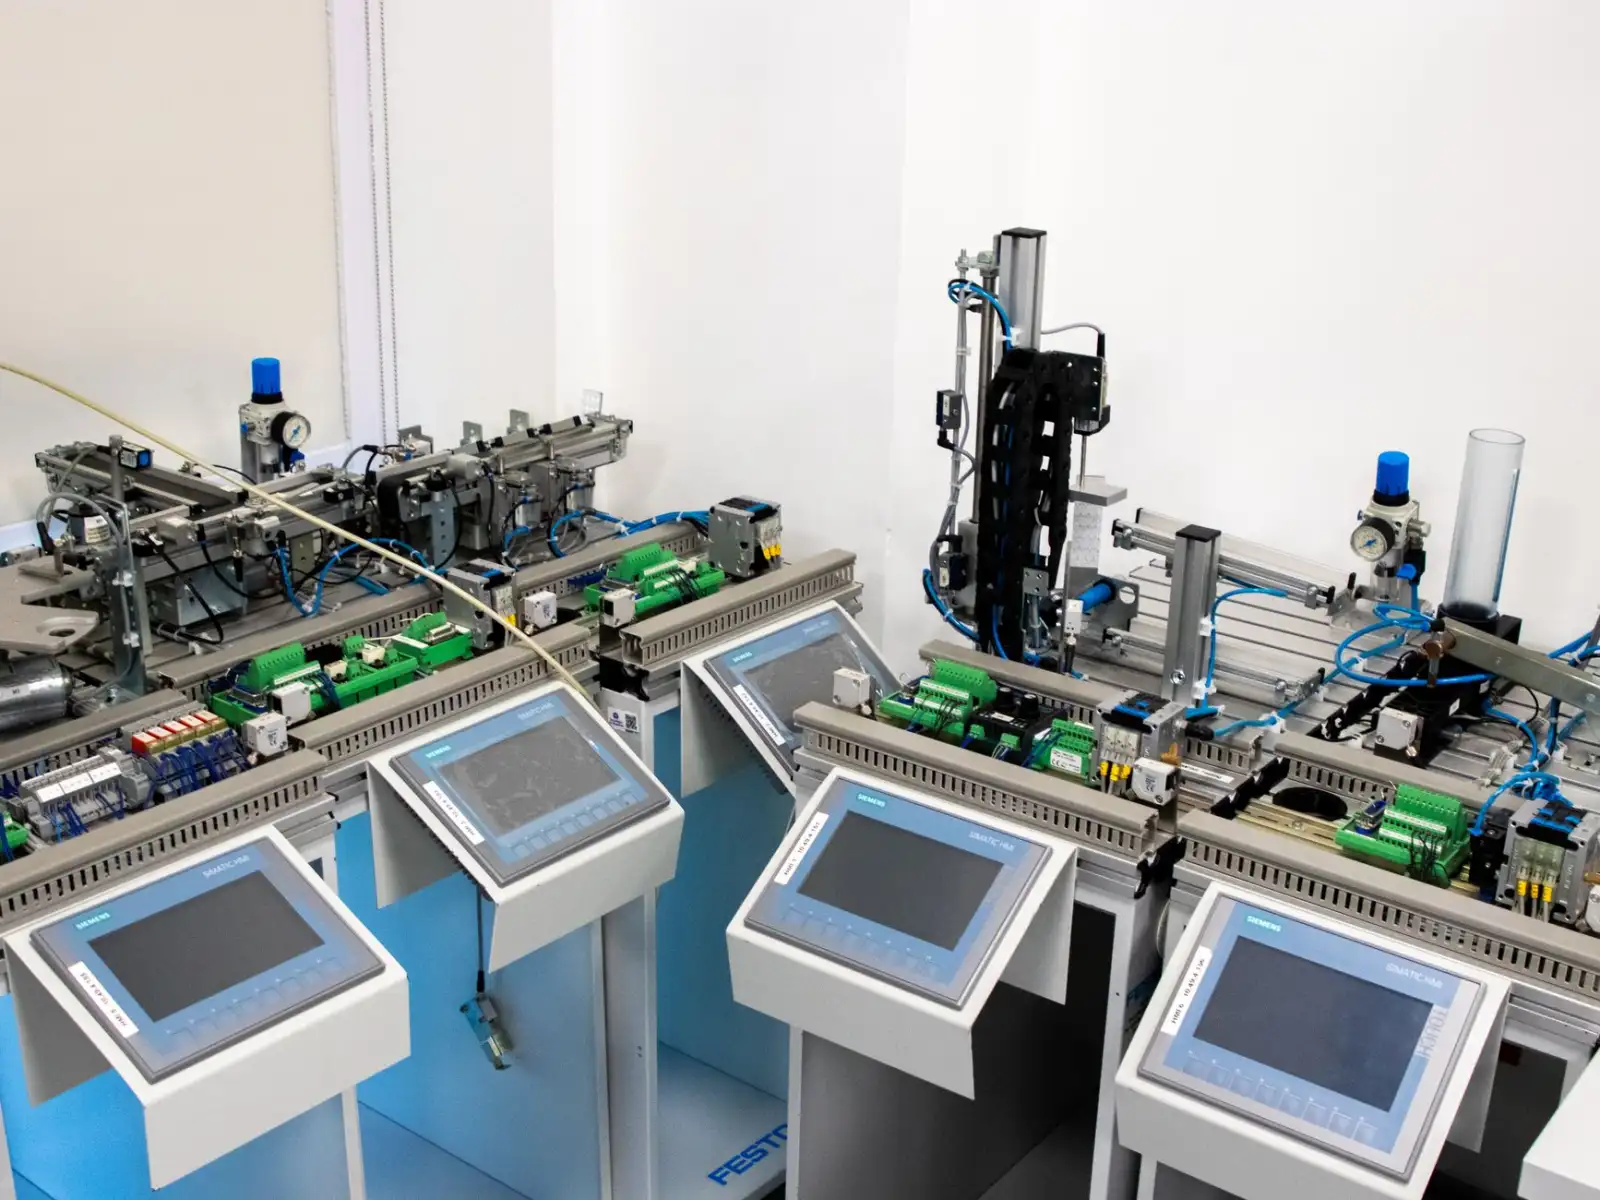
真正的系统集成难点不在“连上”,而在“连稳”。我们常见的集成场景包括:ERP与WMS的库存实时同步、PLC设备数据上云、第三方支付/物流API对接。实施中必须关注三个层面:
- 协议选型:是走RESTful API、消息队列(如RabbitMQ/Kafka)还是OPC UA?这取决于实时性要求与数据量级,高并发场景盲目用HTTP轮询必然导致瓶颈。
- 数据一致性:分布式事务如何处理?我们通常推荐“最终一致性+补偿机制”方案,而非强一致性的分布式锁,后者在跨系统调用时性能损耗极大。
- 容错与监控:集成链路必须设计熔断、重试和死信队列。同时,日志链路追踪(Trace ID)是排查问题的唯一抓手,这一点在南京科技项目的验收标准中应被强制要求。
一次成功的系统集成,不是上线当天跑通流程,而是未来三年内每一次版本迭代都能平滑演进。这意味着在编码阶段就要预留版本控制与灰度发布能力。
南京科技企业的选型指南:自研、外采还是混合?
很多客户问我们:“迪一科技,你们作为软件开发服务商,是不是都建议我们定制开发?”答案是否定的。我们的选型原则很简单:
- 核心业务逻辑(如独特的算法、工艺参数)必须自研或深度定制,这是护城河。
- 通用功能模块(如审批流、权限管理)优先使用成熟开源或商业组件,避免重复造轮子。
- 系统间粘合层(ESB或API网关)建议由专业团队实施,这正是系统集成能力的体现。
以南京某新能源配套企业为例,其生产执行系统选用定制开发,而HR与财务系统采用SaaS化产品,通过我们搭建的集成中台,将生产工单与计件工资自动关联,整体人力成本降低18%,数据准确率提升至99.5%以上。这种混合架构,往往比“一刀切”更具性价比。
从项目交付到长期运维:南京科技生态下的应用前景
展望未来,南京的产业优势集中在软件谷、江北新区以及各高新园区,南京科技的创新氛围浓厚,但企业间的IT能力差异巨大。我们预判,科技研发与AI大模型的结合(如智能排产、预测性维护)将逐步渗透到传统制造业,而这一切的前提,依然是扎实的数据底座与稳定的集成架构。
迪一科技在南京本地化的服务优势在于:我们不仅交付代码,更输出一套可复用的架构规范与运维手册。无论是初创公司的第一个MVP,还是上市公司的核心系统重构,我们都能提供从需求梳理、架构设计、编码实施到后期运维的全生命周期支持。选择一家懂业务、精技术的本地伙伴,比选择一家只会写代码的远距离外包团队,风险要低得多。